
¿Qué es un crawler? Una explicación sencilla y práctica
Puede que tu sitio esté recibiendo visitas de robots en este mismo momento, y eso no es un problema. De hecho, puede ser estupendo. Pero solo si entiendes lo que está pasando.
¿Has oído hablar del término “crawler”? Quizá sí, quizá no. Pero si tienes un sitio web, o estás pensando en tenerlo, debería estar en tu radar.
Crawler es una de esas palabras que suenan a ciencia ficción, pero en la práctica tiene todo que ver con el éxito de tu negocio en Google.
En este artículo explicamos qué es un crawler, cómo funciona, por qué importa para el SEO y en qué se diferencia del temido “scraping de datos”.
¿Qué es un crawler?
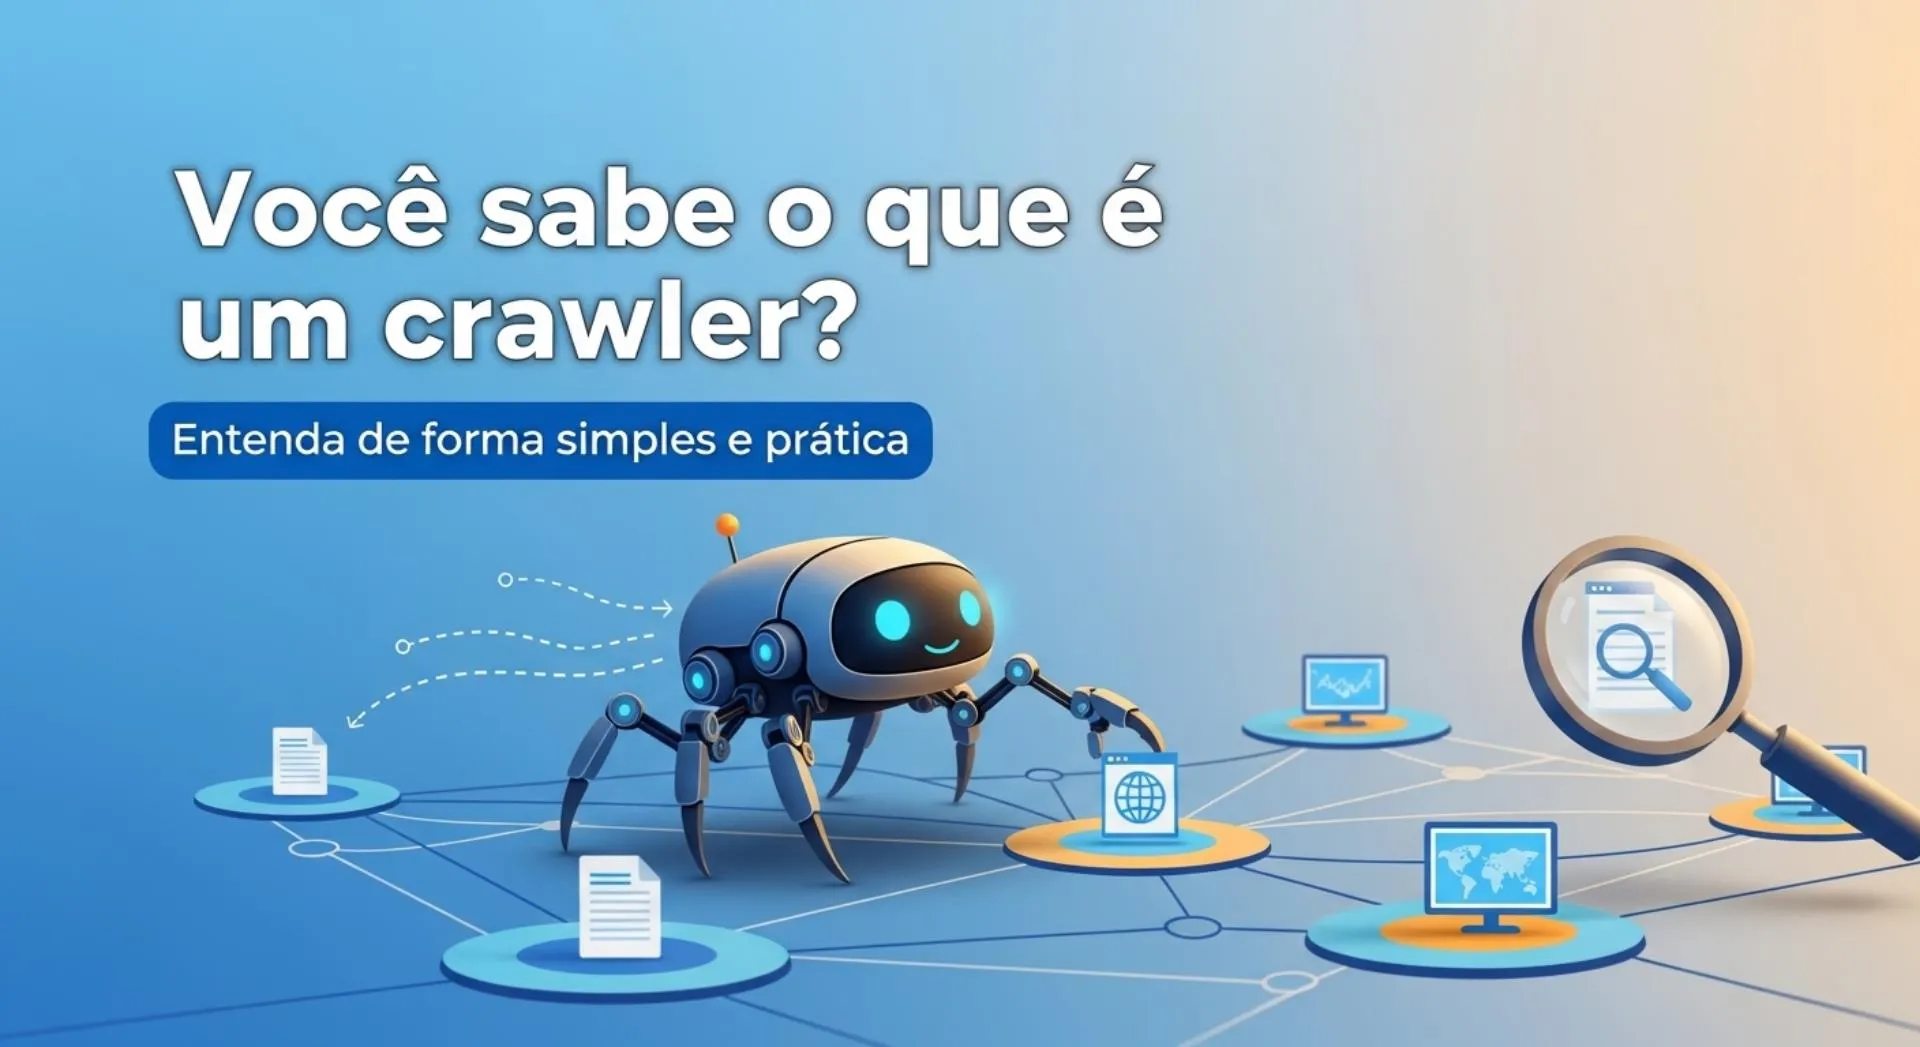
Un crawler (también llamado bot, robot o araña) es un programa automatizado que recorre internet de forma sistemática, leyendo y recopilando información de los sitios web.
Piensa en él como un “robot rastreador” que va haciendo clic en enlaces, leyendo páginas y entendiendo el contenido de cada sitio.
Google, por ejemplo, usa crawlers para descubrir e indexar páginas nuevas. Así es como tu sitio puede aparecer en las búsquedas.
¿Cómo funciona un crawler?
Vamos a lo sencillo. Antes de que puedas buscar algo en Google:
-
El crawler (bot) visita una página.
-
Lee el contenido (textos, enlaces, imágenes, estructura).
-
Sigue los enlaces de la página para visitar otras.
-
Envía esa información a la base de datos del buscador (Google en este ejemplo, pero podría ser cualquier otro).
Es decir, un crawler es como un investigador que explora una ciudad (internet), anota qué hay en cada dirección (los sitios web) y lleva esa información a la sede central (el buscador).
Crawlers que probablemente ya has “alojado” en tu sitio
-
Googlebot: el robot de Google, responsable de indexar tu sitio en las búsquedas.
-
Bingbot: el equivalente de Bing.
-
Facebook External Hit: lo usa Facebook para mostrar las vistas previas de los enlaces.
-
AhrefsBot: lo usan herramientas SEO para analizar sitios.
Estos robots visitan tu sitio con frecuencia. Y si está bien estructurado, entienden mejor el contenido, lo que ayuda a tu posicionamiento.
¿Hace falta permiso para usar un crawler en un sitio web?
Depende. Si estás creando un crawler para uso propio (por ejemplo, para monitorizar los precios de la competencia), debes comprobar si el sitio al que quieres acceder lo permite.
Los sitios pueden bloquear crawlers mediante el archivo robots.txt, que es como un cartel de “prohibido el paso” para los robots.
Los crawlers de los buscadores (como Googlebot), en cambio, son bienvenidos en la mayoría de los sitios. Al fin y al cabo, ¿quién no quiere aparecer en Google?
Rastreo frente a scraping de datos: ¿cuál es la diferencia?
Es una confusión habitual, pero son cosas distintas:
-
Crawler: visita páginas y recopila información automáticamente, siguiendo unas reglas (como el robots.txt).
-
Scraping de datos: extrae datos concretos de forma más agresiva, a menudo ignorando esas reglas.
Un ejemplo práctico:
Crawler: Googlebot visita tu sitio, lee el texto y entiende que vendes patatas fritas.
Scraper: un robot copia todos los precios de tu tienda online en una base de datos externa, sin tu permiso.
En resumen: el rastreo es legítimo y necesario. El scraping puede ser invasivo e incluso ilegal, según el uso que se haga.
¿Qué relación hay entre los crawlers y el SEO?
El SEO (optimización para buscadores) es el conjunto de estrategias para mejorar tu posicionamiento en Google.
¿Y adivinas quién es el primer visitante que necesita entender tu sitio? Exacto, el crawler de Google.
Si el crawler no puede navegar bien por tu sitio, no entiende el contenido. Y si no lo entiende, no apareces en las búsquedas.
Por eso un sitio bien estructurado, con URL claras, contenido organizado y carga rápida, facilita la vida a los crawlers y mejora tu SEO.
Los beneficios de entender (y respetar) a los crawlers
-
Mejor posicionamiento en Google: si el crawler entiende tu sitio, Google también.
-
Visitas más cualificadas: posicionarte bien atrae a personas que buscan de verdad lo que ofreces.
-
Menos problemas técnicos: un sitio preparado para los crawlers suele tener menos errores de indexación.
-
Más credibilidad digital: un sitio que se posiciona bien en Google transmite confianza.
Imagina que tienes una tienda física.
El crawler sería como un evaluador de Google Maps que entra, mira el escaparate, anota lo que vendes, comprueba si hay aparcamiento y si el local está ordenado, y luego publica todo eso en internet.
Si la tienda está desordenada, sin carteles y con las puertas cerradas, se irá sin entender nada.
Con tu sitio web pasa lo mismo.
El crawler puede sonar técnico, pero es uno de los pilares invisibles de tu éxito online
Entender cómo funciona y cómo preparar tu sitio para él es esencial para cualquiera que quiera tener presencia digital.
Y no tienes que hacerlo solo. En Malamute podemos ayudarte, porque es nuestra especialidad: ¡hacer que tu sitio se vea y se encuentre con facilidad!
También disponible en: Português · English · Italiano
¿Quieres convertir la búsqueda orgánica en ingresos?